Preparar documentos para una búsqueda con IA es dejar cada uno en texto limpio, partido en fragmentos que se entienden solos y acompañado de datos que el sistema pueda filtrar: fecha, origen y quién tiene permiso para verlo. Si ese trabajo no se hace, el asistente responde con un párrafo de un manual caducado o no encuentra nada, y la culpa no es del modelo.
En un proyecto así, el tiempo se va en los documentos, no en el modelo.
Qué es RAG y por qué los documentos mandan
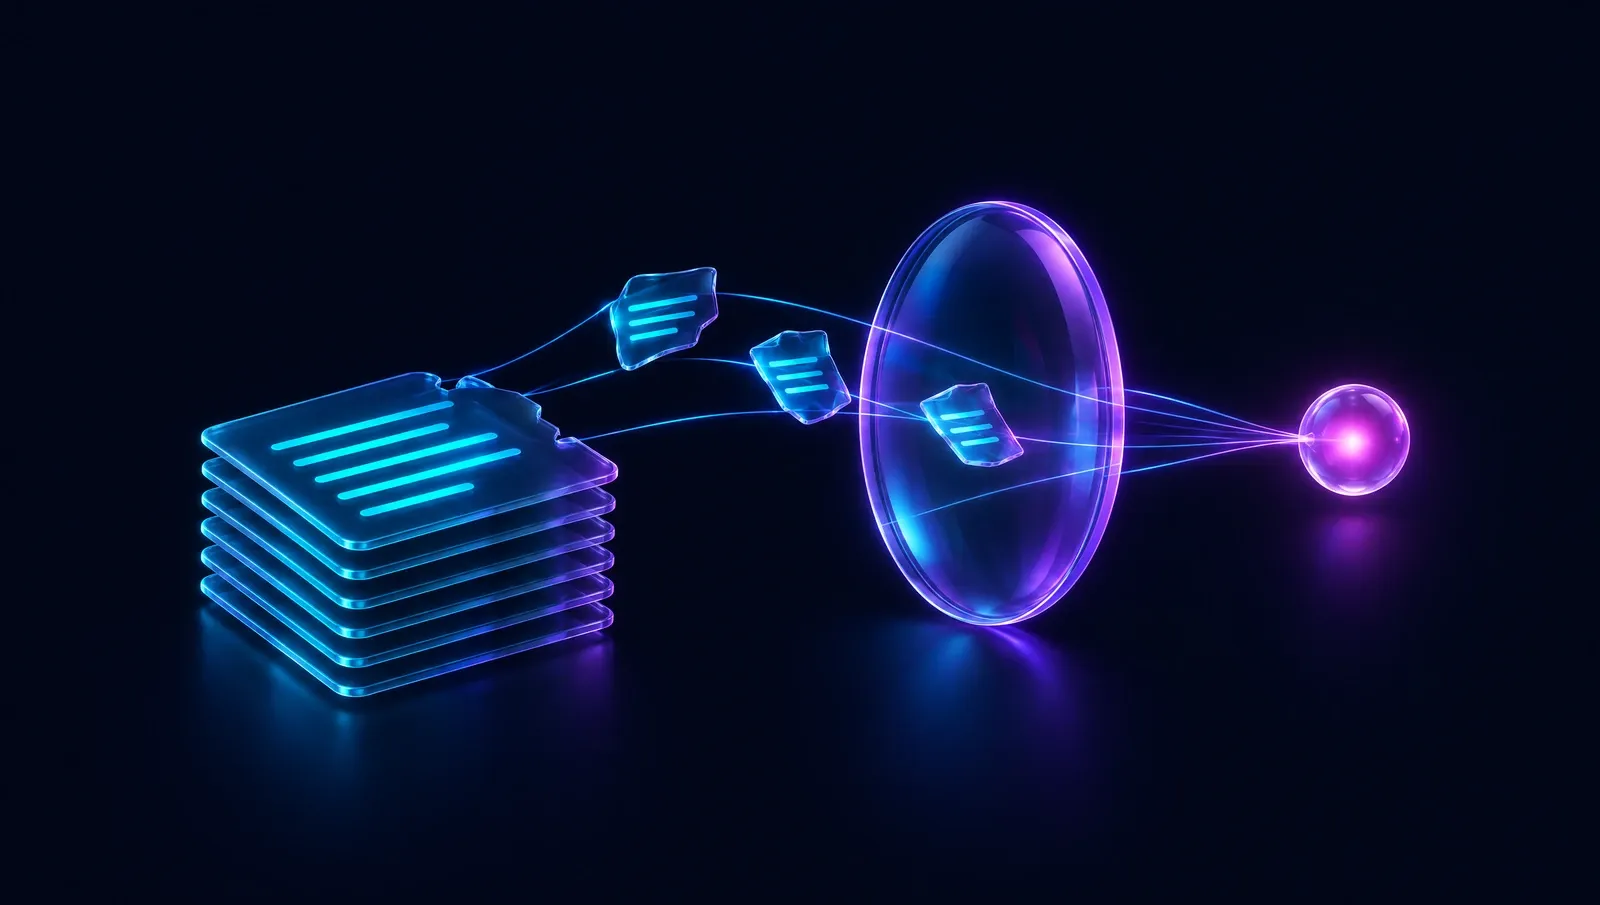
RAG (generación aumentada por recuperación) es la técnica con la que un asistente de IA contesta a partir de tus documentos en vez de a partir de lo que aprendió en su entrenamiento. Funciona en dos tiempos: primero busca en tu base de conocimiento los fragmentos que más se parecen a la pregunta y después se los pasa al modelo para que redacte la respuesta con ellos.
El modelo no lee el manual entero: lee los diez o veinte trozos que la búsqueda le entrega. Si el trozo correcto está mal cortado, duplicado o dentro de una imagen, no llega.
Antes de montar nada, conviene saber si hace falta. Anthropic, en su artículo del 19 de septiembre de 2024 sobre recuperación contextual, lo dice sin rodeos: si la base de conocimiento ocupa menos de 200.000 tokens (unas 500 páginas), se puede incluir entera en cada consulta y no hace falta RAG. Una pyme con un manual y veinte fichas de producto está por debajo; una gestoría con diez años de circulares, no.
Antes de empezar: qué entra y qué se queda fuera
Lo primero es decidir qué documentos son fuente de verdad y quién responde de cada uno.
- Una sola versión vigente de cada documento. Las anteriores se archivan fuera de la base de conocimiento o se marcan como históricas.
- Un responsable por documento: la persona que sabe si sigue valiendo y avisa cuando cambia.
- Fecha de vigencia visible. Un asistente que no sabe de cuándo es una tarifa la dará como actual.
- Fuera lo que nadie firmaría: borradores, correos sueltos, notas de reuniones sin revisar.
La OWASP, en su lista de riesgos de aplicaciones con modelos de lenguaje de 2025, dedica una entrada a las debilidades de vectores y embeddings (LLM08) y pide aceptar «solo datos de fuentes fiables y verificadas» y auditar la base en busca de contenido envenenado u oculto. En una pyme lo habitual es el envenenamiento accidental: alguien sube un documento a medio corregir y el asistente lo cita durante meses.
Cómo preparar cada documento
Texto que una máquina pueda leer
Un PDF escaneado es una foto. Para la búsqueda no contiene palabras hasta que pasa por reconocimiento de texto (OCR), y ese resultado hay que revisarlo: un «0» leído como «O» en un código de producto no se encuentra nunca. Los documentos nacidos en Word, hojas de cálculo o HTML se convierten mejor; la guía de recuperación de OpenAI, por ejemplo, admite PDF, Word, PowerPoint, Markdown, HTML y texto plano, con un máximo de 512 MB por fichero.
Cabeceras, pies de página, numeración y marcas de agua se quitan: si no, cada fragmento arrastra «Página 14 de 92 · Confidencial» y eso compite con el contenido real.
Estructura que sobreviva al corte
El sistema va a partir cada documento en trozos. Un documento con títulos claros, párrafos de una idea y listas cortas se parte bien; un muro de texto de cuatro páginas, no.
- Títulos y subtítulos que digan de qué trata el bloque.
- Un párrafo, una idea. Si mezcla la garantía y la devolución, el fragmento de devoluciones puede quedarse sin la condición que estaba dos frases antes.
- Tablas sencillas, sin celdas combinadas. Una tabla compleja se reescribe en frases («El plan básico incluye 5 usuarios y 10 GB») o se divide.
- Siglas y nombres internos explicados la primera vez: el modelo no sabe qué es «el PRL-3».
Los fragmentos y su contexto
OpenAI, en su guía de recuperación, parte por defecto en fragmentos de 800 tokens con 400 de solapamiento, para que una idea cortada por el borde aparezca entera en el siguiente trozo. Anthropic describe fragmentos que «normalmente no pasan de unos cientos de tokens» y, en sus pruebas, pasar 20 fragmentos al modelo dio mejor resultado que pasar 5 o 10.
Un fragmento suelto pierde el hilo: «la garantía cubre dos años» no dice de qué producto. La respuesta de Anthropic es la recuperación contextual: antes de indexar cada trozo, un modelo le añade una o dos frases que lo sitúan («pertenece a la ficha del modelo X y describe su garantía»). En sus mediciones, ese contexto combinado con búsqueda por palabras clave redujo un 49 % los fallos de recuperación entre los 20 primeros resultados, y un 67 % al añadir un reordenador.
Metadatos que permitan filtrar
Cada fragmento debería llevar el documento de origen, la fecha de vigencia, el tipo (procedimiento, tarifa, contrato, ficha) y el público (clientes, empleados, dirección). Con eso, la búsqueda filtra antes de comparar significados: «solo tarifas vigentes para clientes» deja fuera la mayor parte del ruido. OpenAI permite hasta 16 atributos por fichero y filtrar por ellos antes de la búsqueda semántica.
Permisos: quién puede ver cada respuesta
Si las nóminas y las fichas de producto viven en la misma base sin separación, un empleado de atención al cliente puede preguntar por un salario y obtenerlo.
La OWASP lo pone entre los riesgos de LLM08: en entornos compartidos existe «riesgo de fuga de contexto entre usuarios o consultas», y la medida que propone es un almacén de vectores «consciente de permisos», con particiones de acceso entre grupos de usuarios, además de registros inmutables de la actividad de recuperación.
En la práctica son tres decisiones: a qué colección va cada documento, qué grupo puede consultar cada colección, y que el filtro se aplique en la búsqueda, no en la respuesta. Un modelo al que se le pide «no menciones salarios» no es un control de acceso.
Cómo saber si quedó bien
Antes de darlo por terminado, se prepara una lista de 20 o 30 preguntas reales, con la respuesta correcta y el documento donde está. Se lanza cada una y se mira si el fragmento correcto está entre los que el sistema entregó al modelo. Si no está, el fallo es de preparación o de búsqueda, y cambiar de modelo no sirve de nada.
| Síntoma | Causa habitual | Qué revisar |
|---|---|---|
| Responde con datos viejos | Varias versiones del mismo documento | Una sola vigente y fecha en los metadatos |
| «No encuentro información» con algo que existe | PDF escaneado sin OCR, o tabla rota | Convertir a texto y buscar la cifra a mano |
| Mezcla dos productos en una respuesta | Fragmentos sin contexto o demasiado largos | Títulos por sección y contexto por fragmento |
| Documento correcto, párrafo equivocado | Párrafos con varias ideas | Partir los párrafos; probar un fragmento menor |
| Un usuario ve lo que no debería | Permisos solo en la respuesta | Filtro de permisos en la búsqueda |
Las respuestas deben citar el fragmento que usaron, para que quien las lee pueda comprobarlas.
Preguntas frecuentes
¿Hace falta reescribir todos los documentos?
No. Hace falta convertirlos a texto, quitar lo que no es contenido y dividir los párrafos largos. Se reescriben solo los que fallan en la prueba de preguntas, que suelen ser tablas de precios y condiciones con excepciones.
¿Los documentos salen de la empresa?
Depende de dónde se ejecuten la búsqueda y el modelo. Con un proveedor en la nube, los fragmentos viajan a ese proveedor en cada consulta; con un modelo y un índice en un servidor propio, no salen. Para documentos con datos personales o contratos, esa decisión se toma antes de preparar nada.
¿Cada cuánto hay que actualizar la base de conocimiento?
Cada vez que cambie un documento fuente; por eso cada uno tiene un responsable. Lo cómodo es que la carga sea automática desde la carpeta donde ya viven, con la fecha de modificación como metadato.
El siguiente paso
Si tienes una carpeta de manuales, tarifas o contratos y quieres que tu gente, o tus clientes, pregunten en lugar de buscar, cuéntanos qué documentos son y quién debe verlos en contacto: te diremos si hace falta RAG o basta con algo más simple. Cómo montamos asistentes sobre documentos propios, con permisos y pruebas antes de ponerlos en marcha, está en la página del servicio de inteligencia artificial.
Fuentes
- Anthropic, «Introducing Contextual Retrieval» (19 de septiembre de 2024): anthropic.com/news/contextual-retrieval
- OpenAI, guía «Retrieval» de la plataforma (tamaño de fragmento por defecto, formatos, atributos): developers.openai.com
- OWASP, Top 10 for LLM Applications 2025, LLM08 Vector and Embedding Weaknesses: genai.owasp.org/llmrisk/llm082025‑vector‑and‑embedding‑weaknesses
¿Te ayudamos a llevarlo a tu negocio?
Cuéntanos qué quieres resolver y te diremos qué pieza lo hace y por qué, sin compromiso.
Cuéntanos tu proyecto